מבחן מה"ט אלגוריתמיקה ותכנות (Python) 97103 - קיץ 2025 מועד א'
הנדסת תוכנה · סמל 97103 · 10 שאלות · פתרון מלא לכל סעיף
מבחן הגמר הממלכתי של מה"ט באלגוריתמיקה ותכנות (Python), קיץ 2025 מועד א', כל 10 השאלות כמו בשאלון. לכל סעיף יש תשובה סופית ופתרון מלא ומוסבר, צעד אחרי צעד. נסו לפתור לבד, ואז פתחו את הפתרון.
הנחיות הבחינה
משך הבחינה: ארבע שעות וחצי.
מבנה השאלון: מבחן ב-Python (עמוד 2)
בכל מבחן 10 שאלות.
חלק א' – 36 נקודות
שאלות 1–4: יש לענות על שלוש שאלות בלבד. ערך כל שאלה – 12 נקודות.
חלק ב' – 30 נקודות
שאלות 5–7: יש לענות על שתי שאלות בלבד. ערך כל שאלה – 15 נקודות.
חלק ג' – 34 נקודות
שאלות 8–10: יש לענות על שתי שאלות בלבד. ערך כל שאלה – 17 נקודות.
בסך הכול: 100 נקודות.
חומר עזר: 1. מחשבון (אין להשתמש במחשב כף יד או במחשבון עם תקשורת חיצונית).
2. קלסר אחד בלבד עם חומר ההרצאות. אין להוציא דפים מהקלסר.
אין לצרף ספרים או חוברות עם פתרונות.
שאלה 1 · הצפנת מחרוזת: הסרת רווחים, החלפה והיפוך
בשיטת ההצפנה "סטופיד" משתמשים כדי להצפין מסר סודי ללא שימוש בכלים ואלגוריתמים מתקדמים.
לשיטה שלושה שלבים:
•הסרת רווחים מהמסר המקורי.
•החלפת סדר התווים בכל זוג תווים צמודים (אם מספר התווים אי-זוגי, התו האחרון נשאר ללא שינוי).
•כתיבת התווים מהסוף להתחלה (הפיכת סדר התווים).
אם הטקסט המקורי היה "Hello World!" אז הטקסט המוצפן יהיה "!ldoroWllHe".
Hello World! → HelloWorld! → eHllWorodl! → !ldoroWllHeכתבו פונקציה אשר מקבלת מחרוזת ומחזירה מחרוזת מוצפנת.
◂ פתרון מלא לשאלה 1
פתרון
פונקציה שמסירה את הרווחים, מחליפה כל זוג תווים צמודים (תו אחרון בודד נשאר) ומחזירה את התוצאה בסדר הפוך; עבור "Hello World!" היא מחזירה "!ldoroWllHe".
הרעיון: מבצעים את שלושת השלבים בזה אחר זה, כל אחד על התוצאה של השלב הקודם.
1. הסרת רווחים: `msg.replace(" ", "")` מחזירה מחרוזת חדשה בלי אף רווח.
2. החלפת זוגות: עוברים עם אינדקס `i` בקפיצות של 2 (0, 2, 4, ...) כל עוד יש תו אחריו (`i + 1 < len(text)`), ומוסיפים לתוצאה קודם את `text[i + 1]` ואחריו את `text[i]`. אם אורך המחרוזת אי-זוגי, התו האחרון לא נכנס לאף זוג, ולכן מוסיפים אותו בסוף כמו שהוא.
3. היפוך: עוברים על התווים מההתחלה ומצמידים כל תו לפני התוצאה שנבנתה עד עכשיו (`result = ch + result`), כך שהתו הראשון מגיע לסוף והאחרון להתחלה. (אפשר גם לכתוב בקיצור `swapped[::-1]`.)
def stupid_encrypt(msg):
    # שלב 1: הסרת רווחים
    text = msg.replace(" ", "")
    # שלב 2: החלפת סדר התווים בכל זוג צמוד
    swapped = ""
    i = 0
    while i + 1 < len(text):
        swapped = swapped + text[i + 1] + text[i]
        i = i + 2
    if len(text) % 2 == 1:          # תו אחרון בודד נשאר במקומו
        swapped = swapped + text[-1]
    # שלב 3: הפיכת סדר התווים
    result = ""
    for ch in swapped:
        result = ch + result
return result1. `"Hello World!"` אחרי הסרת הרווח: `"HelloWorld!"` (11 תווים).
2. הזוגות He, ll, oW, or, ld הופכים ל-eH, ll, Wo, ro, dl, והתו הבודד `!` נשאר בסוף: `"eHllWorodl!"`.
3. היפוך: `"!ldoroWllHe"` – בדיוק התוצאה שבשאלה.
סיבוכיות: כל שלב עובר על המחרוזת פעם אחת, ולכן מספר הצעדים פרופורציונלי לאורך המחרוזת.
תשובה: הפונקציה `stupid_encrypt` שלמעלה.
שאלה 2 · מציאת נקודת איזון של מכפלות ברשימה
נתונה רשימה arr בגודל n המכילה מספרים שלמים שונים זה מזה.
נגדיר "נקודת איזון" כאינדקס k ברשימה, כך שמכפלה של כל האיברים משמאל לאינדקס k שווה למכפלה של כל האיברים מימין לאינדקס k (לא כולל האיבר באינדקס k).
כתבו פונקציה שמקבלת רשימה של מספרים שלמים ומחזירה את האינדקס של נקודת האיזון הראשונה מצד שמאל. אם לא קיימת נקודת איזון, הפונקציה תחזיר -1.
◂ פתרון מלא לשאלה 2
פתרון
פונקציה שמחשבת מראש את מכפלות הסיומות, עוברת על k מ-1 עד n-2 עם מכפלת שמאל מצטברת, ומחזירה את ה-k הראשון שבו מכפלת השמאל שווה למכפלת הימין, או -1; למשל עבור [2, 3, 7, 6, 1] מוחזר 2.
נתון: רשימה של מספרים שלמים שונים זה מזה.
מבוקש: האינדקס הקטן ביותר k שבו מכפלת האיברים שמשמאל ל-k שווה למכפלת האיברים שמימין ל-k, או -1.
הנחה: נקודת איזון היא אינדקס שיש לו איברים משני הצדדים, כלומר (לאיבר הראשון אין איברים משמאל ולאחרון אין איברים מימין).
הרעיון: הפתרון הישיר מחשב לכל k מחדש את שתי המכפלות, וזה . אפשר לחסוך:
1. מכפלות סיומת: בונים רשימה `suffix` שבה `suffix[k]` היא מכפלת כל האיברים מאינדקס k ועד הסוף. ממלאים אותה מהסוף להתחלה: `suffix[n] = 1` (מכפלה ריקה), ו-`suffix[k] = suffix[k + 1] * arr[k]`. מכפלת האיברים שמימין ל-k היא `suffix[k + 1]`.
2. מכפלת שמאל מצטברת: משתנה `left` שווה למכפלת האיברים שמשמאל לאינדקס הנוכחי. לפני k=1 הוא `arr[0]`, ואחרי בדיקת כל k מכפילים אותו ב-`arr[k]`.
3. עוברים על k מ-1 עד n-2, ובכל צעד משווים `left` ל-`suffix[k + 1]`. בהתאמה הראשונה מחזירים k (זו נקודת האיזון הראשונה משמאל, כי עוברים משמאל לימין). אם הלולאה הסתיימה בלי התאמה, מחזירים -1.
חשוב לאתחל את המכפלות ב-1 (האיבר הנייטרלי לכפל) ולא ב-0, אחרת כל המכפלות יהיו 0.
הערה: אם מתייחסים גם לקצוות ומגדירים שמכפלה ריקה שווה 1, אפשר לעבור על k מ-0 עד n-1 (עם `left = 1` בהתחלה); למשל עבור `[5]` יוחזר אז 0.
def balance(arr):
    n = len(arr)
    # suffix[k] = מכפלת האיברים מאינדקס k ועד הסוף
    suffix = [1] * (n + 1)
    for k in range(n - 1, -1, -1):
        suffix[k] = suffix[k + 1] * arr[k]
    left = arr[0] if n > 0 else 1   # מכפלת האיברים משמאל לאינדקס 1
    for k in range(1, n - 1):
        if left == suffix[k + 1]:
            return k
        left = left * arr[k]
    return -1
דוגמה: עבור `[2, 3, 7, 6, 1]`:
•: משמאל , מימין – לא שווה.
•: משמאל , מימין – שווה, ולכן מוחזר 2.
עבור `[1, 2, 3]`: ב- משמאל 1 ומימין 3, ולכן מוחזר -1.
סיבוכיות: שני מעברים על הרשימה – .
תשובה: הפונקציה `balance` שלמעלה.
שאלה 3 · מעקב: הרצף הארוך ביותר של זוגיים
נתונה הפונקציה what:
def what(arr):
    c = 0
    m = 0
    for i in range(len(arr)):
        if arr[i] % 2 == 0:
            c += 1
        else:
            if c > m:
                m = c
            c = 0
    if c > m:
        return c
return mנתונה רשימה `arr = [12, 6, 3, 17, 4, 5, 2, 8, 10, 13]`.
עקבו אחרי זימון `what(arr)` ורשמו מה תהיה תוצאת הזימון. יש להראות מעקב אחרי ביצוע!
תנו דוגמה לרשימה arr בגודל שישה איברים הכוללת מספרים שלמים שונים זה מזה, שעבורה הפונקציה what תחזיר את הערך ארבע.
מהו הערך הקטן ביותר שהפונקציה what יכולה להחזיר? תנו דוגמה לרשימה arr בגודל שישה איברים הכוללת מספרים שלמים שונים זה מזה, שעבורה הפונקציה what תחזיר ערך זה.
מה מבצעת הפונקציה what באופן כללי?
◂ פתרון מלא לשאלה 3
סעיף א
הזימון מחזיר 3.
הפונקציה עוברת על הרשימה עם שני משתנים: `c` – אורך רצף המספרים הזוגיים הנוכחי, ו-`m` – אורך הרצף הארוך ביותר שנסגר עד כה. במספר זוגי `c` גדל ב-1; במספר אי-זוגי הרצף נסגר: אם `c > m` מעדכנים `m = c`, ואז מאפסים את `c`.
אחרי הלולאה: `c = 0`, והתנאי `c > m` () לא מתקיים, ולכן מוחזר `m = 3`.
תשובה: 3.
סעיף ב
למשל `[1, 2, 4, 6, 8, 3]`.
הפונקציה מחזירה את אורך הרצף הארוך ביותר של מספרים זוגיים צמודים (ראו סעיף ד). לכן צריך רשימה של שישה מספרים שונים שבה יש רצף של 4 זוגיים צמודים, ושאר האיברים אי-זוגיים כדי שלא ייווצר רצף ארוך יותר:
`arr = [1, 2, 4, 6, 8, 3]`
מעקב קצר: ב-1 הרצף מתאפס (); ב-2, 4, 6, 8 הערך של c עולה ל-4; ב-3 נסגר הרצף ו-. בסוף , ולכן מוחזר 4.
תשובה: `[1, 2, 4, 6, 8, 3]`.
סעיף ג
הערך הקטן ביותר הוא 0, למשל עבור `[1, 3, 5, 7, 9, 11]`.
המשתנים `c` ו-`m` מתחילים ב-0 ורק גדלים או מתאפסים, ולכן הפונקציה לא יכולה להחזיר ערך שלילי. הערך 0 מתקבל כשאין ברשימה אף מספר זוגי: אז `c` נשאר 0 כל הזמן, `m` לא מתעדכן, ומוחזר 0.
דוגמה: `arr = [1, 3, 5, 7, 9, 11]` – כל האיברים אי-זוגיים, ולכן מוחזר 0.
תשובה: הערך הקטן ביותר הוא 0, למשל עבור `[1, 3, 5, 7, 9, 11]`.
סעיף ד
מחזירה את אורך הרצף הארוך ביותר של מספרים זוגיים צמודים ברשימה (0 אם אין זוגיים).
`c` סופר כמה מספרים זוגיים הופיעו ברצף מאז המספר האי-זוגי האחרון. בכל פעם שמגיע מספר אי-זוגי, הרצף נסגר והאורך שלו נשמר ב-`m` אם הוא ארוך מהשיא. הבדיקה שאחרי הלולאה מטפלת ברצף שמסתיים בסוף הרשימה (שלא נסגר על ידי מספר אי-זוגי).
תשובה: הפונקציה מחזירה את מספר האיברים ברצף הארוך ביותר של מספרים זוגיים צמודים ברשימה (0 אם אין מספר זוגי).
שאלה 4 · מחלקת עובד: חישוב שכר ומשכורות מעל הממוצע
במפעל יש שני סוגים של עובדים: פועלים ומהנדסים. שכרו של כל עובד מחושב כך:
•עבור כל אחת מ-160 שעות הראשונות פועל מקבל 80 ₪ לשעת העבודה ומהנדס – 150 ₪.
•עבור כל שעה נוספת העובד מקבל תוספת של 70 ₪.
נתונה מחלקה בשם Employee עם התכונות האלה:
•id – מחרוזת המייצגת את מספר הזהות של העובד.
•status – מספר שלם המייצג את סוג העובד (1 עבור מהנדס, 2 עבור פועל).
•hours – מספר שלם המייצג את סך שעות העבודה של העובד בחודש.
class Employee:
    def __init__(self, id, status):
        self.id = id
        self.status = status
        self.hours = 0
במחלקה הוגדרו כל הפעולות set ו-get וגם הפונקציה `__str__`.
כתבו במחלקה Employee פונקציה `get_salary()` לחישוב משכורת חודשית של עובד.
כותרת הפונקציה:
def get_salary (self)לפניכם קטע תוכנית לקליטת נתוני שכר של עובד מסוים. עבור כל אחד מ-25 ימי העבודה בחודש ייקלטו שעת תחילת העבודה ושעת סיום העבודה. אחרי קליטת הנתונים, הקטע ידפיס את שכרו של העובד.
השלימו את החסר:
n=  ___________(1)_____________
t=  ___________(2)_____________

emp = ___________(3)_____

s = 0
for element in range(25):
   a=int(input("שעת התחלה"))
   b=int(input("שעת סיום"))
   s=    ___________(4)___

emp.set_hours(____(5)__)
print(________(6)_______)כתבו פונקציה אשר מקבלת רשימה של אובייקטים המכילים את נתוני השכר של כל עובדי המפעל. על הפונקציה להדפיס את מספרי הזהות של הפועלים אשר משכורתם גבוהה מממוצע המשכורות של המהנדסים.
◂ פתרון מלא לשאלה 4
סעיף א
עד 160 שעות: שעות × תעריף (150 ₪ למהנדס, 80 ₪ לפועל); מעל 160: תעריף ועוד 70 ₪ לכל שעה נוספת.
נתון: סוג העובד (`status`) ומספר השעות בחודש (`hours`).
מבוקש: המשכורת החודשית.
1. בוחרים תעריף לפי סוג העובד: 150 ₪ למהנדס (`status == 1`), 80 ₪ לפועל.
2. אם העובד עבד עד 160 שעות, כל השעות משולמות בתעריף: שעות × תעריף.
3. אחרת, 160 השעות הראשונות משולמות בתעריף, וכל שעה נוספת (`hours - 160`) משולמת ב-70 ₪.
def get_salary(self):
    if self.status == 1:          # מהנדס
        rate = 150
    else:                         # פועל
        rate = 80
    if self.hours <= 160:
        return self.hours * rate
    extra = self.hours - 160
return 160 * rate + extra * 70•מהנדס שעבד 170 שעות: ₪.
•פועל שעבד 150 שעות: ₪.
•פועל שעבד 200 שעות: ₪.
תשובה: הפעולה `get_salary` שלמעלה.
סעיף ב
(1) `input("תעודת זהות: ")`; (2) `int(input("סוג העובד (1=מהנדס, 2=פועל): "))`; (3) `Employee(n, t)`; (4) `s + (b - a)`; (5) `s`; (6) `emp.get_salary()`.
עוברים על החסרים לפי הסדר ושואלים מה כל שורה צריכה לעשות:
1. (1) `n` הוא מספר הזהות – לפי ההגדרה זו מחרוזת, ולכן קולטים בלי המרה: `input("תעודת זהות: ")`.
2. (2) `t` הוא סוג העובד – מספר שלם (1 או 2), ולכן ממירים: `int(input("סוג העובד (1=מהנדס, 2=פועל): "))`.
3. (3) יוצרים עצם של עובד עם הבנאי, שמקבל מספר זהות וסוג: `Employee(n, t)`.
4. (4) בכל יום מספר שעות העבודה הוא (שעת הסיום פחות שעת ההתחלה). `s` הוא צובר, ולכן מוסיפים לו את שעות היום: `s + (b - a)`. (אם נכתוב רק `b - a`, יישמרו רק השעות של היום האחרון.)
5. (5) אחרי הלולאה `s` הוא סך השעות בחודש, ומעבירים אותו לעצם: `emp.set_hours(s)`.
6. (6) מדפיסים את השכר שמחושב בפעולה מסעיף א: `print(emp.get_salary())`.
הקטע המלא:
n = input("תעודת זהות: ")
t = int(input("סוג העובד (1=מהנדס, 2=פועל): "))

emp = Employee(n, t)

s = 0
for element in range(25):
    a = int(input("שעת התחלה"))
    b = int(input("שעת סיום"))
    s = s + (b - a)

emp.set_hours(s)
print(emp.get_salary())
תשובה: (1) `input("תעודת זהות: ")`, (2) `int(input("סוג העובד (1=מהנדס, 2=פועל): "))`, (3) `Employee(n, t)`, (4) `s + (b - a)`, (5) `s`, (6) `emp.get_salary()`.
סעיף ג
מעבר ראשון מחשב את ממוצע משכורות המהנדסים (סכום חלקי מספר); מעבר שני מדפיס את ה-id של כל פועל ש-`get_salary()` שלו גדול מהממוצע.
נתון: רשימת עצמים מסוג Employee.
מבוקש: להדפיס את מספרי הזהות של הפועלים שמשכורתם גבוהה מממוצע משכורות המהנדסים.
1. מעבר ראשון – ממוצע המהנדסים: עוברים על כל העובדים, ולכל מהנדס (`status == 1`) מוסיפים את `get_salary()` לצובר `total` ומגדילים מונה `count`. הממוצע הוא `total / count`.
2. אם אין אף מהנדס (`count == 0`), אי אפשר לחשב ממוצע (חלוקה ב-0) – מדפיסים הודעה ויוצאים.
3. מעבר שני – השוואה: עוברים שוב על העובדים, ולכל פועל (`status == 2`) שמשכורתו גדולה מהממוצע מדפיסים את מספר הזהות שלו.
צריך שני מעברים, כי אי אפשר לדעת אם פועל מעל הממוצע לפני שמכירים את כל המהנדסים. המשכורת מחושבת תמיד בפעולה `get_salary` מסעיף א.
def print_above_avg_workers(employees):
    total = 0
    count = 0
    for emp in employees:
        if emp.get_status() == 1:
            total = total + emp.get_salary()
            count = count + 1
    if count == 0:
        print("אין מהנדסים במפעל")
        return
    avg = total / count
    for emp in employees:
        if emp.get_status() == 2 and emp.get_salary() > avg:
            print(emp.get_id())
דוגמה: שני מהנדסים עם 160 ו-100 שעות מרוויחים 24000 ₪ ו-15000 ₪, והממוצע הוא ₪. פועל עם 250 שעות מרוויח ₪ – לא מעל הממוצע, ולכן לא יודפס. פועל עם 300 שעות מרוויח ₪ ויודפס.
סיבוכיות: שני מעברים על הרשימה – .
תשובה: הפונקציה `print_above_avg_workers` שלמעלה.
שאלה 5 · מספרים ראשוניים והשערת גולדבך
הגדרה: מספר ראשוני הוא מספר שלם חיובי שמתחלק בלי שארית רק ב-1 ובעצמו.
כתבו פונקציה המקבלת מספר שלם וחיובי ובודקת אם הוא ראשוני. אם כן – הפונקציה תחזיר ערך True, ואם לא – הפונקציה תחזיר ערך False.
כותרת הפונקציה:
def is_primary(num)• (או )
• (או )
• (או או או )
• (או או )
כתבו פונקציה המקבלת מספר שלם זוגי num. הפונקציה תחזיר את מספר הזוגות של המספרים הראשוניים אשר סכומם שווה למספר num.
כותרת הפונקציה:
def count_primary_pairs(num)כתבו פונקציה המקבלת מספר שלם זוגי num. הפונקציה תחזיר רשימה (list) של כל זוגות המספרים הראשוניים שסכומם שווה לו. כל זוג יוצג כטאפל (tuple) או כרשימה קטנה יותר בתוך הרשימה הגדולה.
עבור המספר 42 הפונקציה תחזיר את הרשימה הזאת:
[(1, 41), (5, 37), (11, 31), (13, 29), (19, 23)]כי:
•
•
•
•
•
כותרת הפונקציה:
def all_primary_pairs(num)מהי סיבוכיות זמן הריצה של כל הפעולות שכתבתם? הסבירו את תשובתכם.
◂ פתרון מלא לשאלה 5
סעיף א
בודקים מחלקים מ-2 עד ; אם נמצא מחלק מחזירים False, אחרת True (לפי ההגדרה והדוגמאות בשאלה גם 1 נחשב ראשוני).
הרעיון: מספר אינו ראשוני אם יש לו מחלק בין 2 ל-num-1. מספיק לבדוק מחלקים עד : אם ושני הגורמים גדולים מ-, המכפלה שלהם גדולה מ-num. לכן אם יש מחלק, יש גם אחד שקטן או שווה ל-.
1. מתחילים ב-`i = 2` וממשיכים כל עוד (כך לא צריך לחשב שורש).
2. אם `num % i == 0` נמצא מחלק – מחזירים `False` מיד.
3. אם הלולאה הסתיימה בלי מחלק – מחזירים `True`.
הערה: לפי ההגדרה בשאלה ("מתחלק רק ב-1 ובעצמו") ולפי הדוגמאות שלה (, ), המספר 1 נחשב כאן ראשוני, וזה מה שהפונקציה מחזירה (עבור 1 הלולאה לא מתבצעת). במתמטיקה המקובלת 1 אינו ראשוני.
def is_primary(num):
    if num < 1:
        return False
    i = 2
    while i * i <= num:
        if num % i == 0:
            return False
        i = i + 1
    return True
דוגמאות: עבור 29 בודקים את 2, 3, 4, 5 () – אין מחלק, מוחזר `True`. עבור 91 נמצא המחלק 7 (), מוחזר `False`.
תשובה: הפונקציה `is_primary` שלמעלה.
סעיף ב
לולאה על i מ-1 עד num/2; סופרים את ה-i שעבורם גם i וגם num-i ראשוניים. למשל עבור 24 מוחזר 4.
הרעיון: כל זוג הוא . כדי לא לספור אותו זוג פעמיים (למשל ו-), עוברים רק על המספר הקטן בזוג: . הגבול כלול, כדי לספור זוג של שני מספרים שווים כמו .
1. מאתחלים מונה `count = 0`.
2. לכל i בתחום בודקים בעזרת הפונקציה מסעיף א אם גם i וגם `num - i` ראשוניים; אם כן – מגדילים את המונה.
3. מחזירים את המונה.
def count_primary_pairs(num):
    count = 0
    for i in range(1, num // 2 + 1):
        if is_primary(i) and is_primary(num - i):
            count = count + 1
return count•עבור 8: הזוגות , – מוחזר 2.
•עבור 24: , , , – מוחזר 4.
•עבור 46: , , , – מוחזר 4 (בדוגמה שבשאלה לא הופיע הזוג , אבל גם הוא זוג של ראשוניים).
תשובה: הפונקציה `count_primary_pairs` שלמעלה.
סעיף ג
אותה לולאה כמו בסעיף ב, אבל במקום לספור מוסיפים לרשימה את הטאפל `(i, num - i)`; עבור 42 מוחזר `[(1, 41), (5, 37), (11, 31), (13, 29), (19, 23)]`.
הרעיון: אותו מעבר כמו בסעיף ב, אבל במקום מונה בונים רשימה.
1. מאתחלים רשימה ריקה `pairs`.
2. לכל i מ-1 עד : אם i ו-`num - i` ראשוניים, מוסיפים את הטאפל `(i, num - i)`. המספר הקטן ראשון, כמו בדוגמה.
3. מחזירים את הרשימה. מכיוון ש-i עולה, הזוגות יוצאים מסודרים לפי המספר הקטן.
def all_primary_pairs(num):
    pairs = []
    for i in range(1, num // 2 + 1):
        if is_primary(i) and is_primary(num - i):
            pairs.append((i, num - i))
    return pairs
בדיקה עם 42: i עובר מ-1 עד 21. מתקבלים הזוגות שבהם שני המספרים ראשוניים: , , , , . ערכים אחרים נפסלים, למשל כי , ו- כי . התוצאה זהה לדוגמה.
תשובה: הפונקציה `all_primary_pairs` שלמעלה.
סעיף ד
כאשר הוא הערך של num: `is_primary` – ; `count_primary_pairs` ו-`all_primary_pairs` – .
נסמן ב- את ערך המספר num שהפונקציה מקבלת (הקלט הוא מספר אחד, ולכן הסיבוכיות נמדדת לפי גודלו).
1. `is_primary(num)`: הלולאה רצה כל עוד , כלומר לכל היותר כ- סיבובים, ובכל סיבוב פעולה קבועה. סיבוכיות: .
2. `count_primary_pairs(num)`: הלולאה רצה סיבובים. בכל סיבוב יש לכל היותר שתי קריאות ל-`is_primary` על מספרים קטנים מ-, כל אחת . סך הכול .
3. `all_primary_pairs(num)`: אותו מבנה, וההוספה לרשימה (`append`) היא . לכן גם כאן .
תשובה: `is_primary` – ; `count_primary_pairs` ו-`all_primary_pairs` – , כאשר הוא ערך num.
שאלה 6 · מחלקת מחסן דגלים: הוספה, חיפוש וסיכום
מפעל לייצור דגלים של מדינות שונות מעוניין במערכת ניהול מלאי ממוחשבת.
לשם כך הוגדרה המחלקה "דגל" (Flag) ולה כמה תכונות:
•שם מדינה (country) – מחרוזת (str)
•אורך (length) – מספר שלם (int)
•רוחב (width) – מספר שלם (int)
במחלקה הוגדרה פונקציה בונה (`__init__`) המקבלת ערכים לכל התכונות והפעולות get/set (מאפיינים) והפעולה `__str__`.
הגדירו מחלקה בשם "מחסן דגלים" (Warehouse) הכוללת את התכונות האלה:
•רשימה של דגלים (flags) – רשימה של עצמים מסוג "דגל" (Flag) בגודל מקסימלי של 100.
•רשימה של כמויות (quantities) – רשימה של מספרים שלמים (int) באותו הגודל של רשימת הדגלים, שבה כל תא מציין את הכמות של הדגל המתאים ברשימת הדגלים (הדגל במקום ה-i ברשימת הדגלים מתאים לכמות במקום ה-i ברשימת הכמויות).
•מספר הדגלים הנוכחי במחסן (current_flags) – מספר שלם (int).
כתבו פונקציה בונה (`__init__`) למחלקה המאתחלת את רשימת הדגלים, את רשימת הכמויות בגודל 100 ואת מספר הדגלים הנוכחי ל-0.
כתבו במחלקה "מחסן דגלים" פונקציה המקבלת שם מדינה, אורך ורוחב של דגל ומספר דגלים, ומוסיפה את הדגל למחסן. אם כבר קיים דגל זהה במחסן, הפונקציה תעדכן את הכמות שלו. אם המחסן מלא, הפונקציה תדפיס הודעה מתאימה.
כותרת הפונקציה:
def add(self, country, length, width, quantity)כתבו במחלקה "מחסן דגלים" פונקציה המקבלת מספר שלם המייצג כמות מינימלית ומדפיסה את שמות הפרטים של כל הדגלים במחסן שנמצאים בכמות הקטנה מהכמות המינימלית.
כותרת הפונקציה:
def flags_with_min_quantity(self, min_quantity)לקראת ביקור ראשי מדינות שונות יש להכין דגלים לקישוט העיר. כתבו במחלקה "מחסן דגלים" פונקציה המקבלת רשימה של שמות מדינות (רשימה של מחרוזות) ומדפיסה עבור כל מדינה ברשימה את כמות של כל הדגלים שלה הקיימים במחסן. שימו לב שבמחסן יכולים להיות דגלים שונים של אותה מדינה!
כותרת הפונקציה:
def print_flags(self, countries)◂ פתרון מלא לשאלה 6
סעיף א
`flags = [None] * 100`, `quantities = [0] * 100`, `current_flags = 0`.
הרעיון: שתי רשימות מקבילות בגודל קבוע 100: במקום i ברשימת הדגלים נמצא דגל, ובאותו מקום ברשימת הכמויות – כמה יחידות ממנו יש במחסן. `current_flags` אומר כמה מקומות בתחילת הרשימות תפוסים בפועל (המקומות עד `current_flags - 1`).
1. `flags` מאותחלת ב-100 תאים ריקים (`None`), כי עדיין אין דגלים.
2. `quantities` מאותחלת ב-100 אפסים.
3. `current_flags` מאותחל ל-0.
class Warehouse:
    def __init__(self):
        self.flags = [None] * 100
        self.quantities = [0] * 100
        self.current_flags = 0
תשובה: המחלקה Warehouse עם הבנאי שלמעלה.
סעיף ב
מחפשים דגל זהה (מדינה, אורך ורוחב) בין `current_flags` הדגלים; אם נמצא – מוסיפים לכמות שלו; אחרת, אם המחסן מלא מדפיסים הודעה, ואם לא – יוצרים Flag חדש במקום `current_flags`, שומרים את הכמות ומגדילים את המונה.
הרעיון: דגל "זהה" הוא דגל עם אותה מדינה, אותו אורך ואותו רוחב.
1. חיפוש דגל זהה: עוברים רק על המקומות התפוסים (`range(self.current_flags)`), ומשווים את שלוש התכונות בעזרת פעולות ה-get. אם נמצא דגל זהה, מוסיפים את `quantity` לכמות שבאותו אינדקס ויוצאים.
2. המחסן מלא: אם לא נמצא דגל זהה ו-`current_flags` כבר 100, אין מקום לדגל חדש – מדפיסים הודעה ויוצאים. את הבדיקה הזאת עושים אחרי החיפוש, כי גם במחסן מלא אפשר לעדכן כמות של דגל קיים.
3. דגל חדש: יוצרים עצם `Flag` ושמים אותו במקום הפנוי הראשון (`current_flags`), שומרים באותו מקום את הכמות, ומגדילים את `current_flags` ב-1.
def add(self, country, length, width, quantity):
    # חיפוש דגל זהה בין הדגלים הקיימים
    for i in range(self.current_flags):
        f = self.flags[i]
        if (f.get_country() == country and f.get_length() == length
                and f.get_width() == width):
            self.quantities[i] = self.quantities[i] + quantity
            return
    # דגל חדש
    if self.current_flags == 100:
        print("המחסן מלא, אי אפשר להוסיף דגל חדש")
        return
    self.flags[self.current_flags] = Flag(country, length, width)
    self.quantities[self.current_flags] = quantity
    self.current_flags = self.current_flags + 1
דוגמה: `add("Israel", 150, 100, 20)` ואחריו `add("Israel", 150, 100, 10)` – בפעם הראשונה נוצר דגל חדש בכמות 20, ובפעם השנייה הכמות שלו מתעדכנת ל-30. `add("Israel", 90, 60, 3)` יוצר דגל נפרד, כי המידות שונות.
תשובה: הפעולה `add` שלמעלה.
סעיף ג
לולאה על `current_flags` הדגלים; לכל דגל שכמותו קטנה מ-`min_quantity` מדפיסים אותו (באמצעות `__str__`) ואת הכמות שלו.
הרעיון: הכמות של הדגל במקום i נמצאת ב-`quantities[i]`. עוברים על המקומות התפוסים בלבד (עד `current_flags`, לא עד 100, כי שאר התאים ריקים), ובכל מקום שבו הכמות קטנה מ-`min_quantity` מדפיסים את הדגל. `print` על עצם Flag משתמש בפעולה `__str__` שלו, ולכן מודפסים כל פרטי הדגל, ולידם הכמות.
def flags_with_min_quantity(self, min_quantity):
    for i in range(self.current_flags):
        if self.quantities[i] < min_quantity:
            print(self.flags[i], "- כמות:", self.quantities[i])
דוגמה: במחסן יש Israel 150x100 בכמות 30, France 120x80 בכמות 5 ו-Israel 90x60 בכמות 3. עבור `min_quantity = 10` יודפסו שני האחרונים.
תשובה: הפעולה `flags_with_min_quantity` שלמעלה.
סעיף ד
לולאה חיצונית על המדינות; לכל מדינה מאפסים צובר, עוברים על כל הדגלים במחסן ומסכמים את הכמויות של הדגלים שלה, ומדפיסים את שם המדינה ואת הסכום.
הרעיון: למדינה אחת יכולים להיות כמה דגלים במידות שונות, ולכן לכל מדינה צריך לסכם את הכמויות של כל הדגלים שלה.
1. לולאה חיצונית על שמות המדינות ברשימה `countries`.
2. לכל מדינה מאפסים צובר `total` (האיפוס בתוך הלולאה החיצונית, כדי שכל מדינה תתחיל מ-0).
3. לולאה פנימית על הדגלים במחסן (עד `current_flags`): אם המדינה של הדגל היא המדינה הנוכחית, מוסיפים את הכמות שלו לצובר.
4. בסוף הלולאה הפנימית מדפיסים את שם המדינה ואת הסכום (0 אם אין לה דגלים במחסן).
def print_flags(self, countries):
    for country in countries:
        total = 0
        for i in range(self.current_flags):
            if self.flags[i].get_country() == country:
                total = total + self.quantities[i]
        print(country, ":", total)
דוגמה: עם המחסן מסעיף ג, עבור `["Israel", "France", "Japan"]` יודפס: Israel : 33 (כי ), France : 5, Japan : 0.
סיבוכיות: לכל אחת מ- המדינות עוברים על הדגלים – .
תשובה: הפעולה `print_flags` שלמעלה.
שאלה 7 · רקורסיה: ממוצע ספרות וחלוקת רשימה
נתונות ארבע פעולות:
def one(num):
    return two(num, 0, 0)

def two(num, s, c):

    if num == 0:
        return s / c if c != 0 else 0.0
    return two(num // 10, s + (num % 10), c + 1)

def three(arr, p):
    n = len(arr)
    temp = [0] * n
    four(arr, temp, 0, 0, n - 1, p)
    return temp

def four(arr, temp, k, left, right, p):
    if k <len(arr):
        if one(arr[k]) > one(arr[p]):
            temp[right] = arr[k]
            four(arr, temp, k + 1, left, right - 1, p)
        else:
            temp[left] = arr[k]
four(arr, temp, k + 1, left + 1, right, p)עקבו אחרי זימון הפונקציה `one(6123)` ורשמו את תוצאת הזימון. יש להראות מעקב!
תנו דוגמה של מספר שלם וחיובי גדול מ-100 שעבורו הפונקציה תחזיר ערך חמש.
מה מבצעת הפונקציה `one(num)` עבור מספר שלם num?
נתונה הרשימה `a = [24, 126, 9, 35, 2684, 8941]`
עקבו אחרי זימון הפונקציה `three(a, 3)` ורשמו מה תהיה תוצאת הזימון.
האם קיים ערך p שעבורו זימון הפונקציה `three(a, p)` יגרום לשגיאה? הסבירו את תשובתכם.
תנו דוגמה לרשימה arr בגודל שישה איברים כך שזימון הפונקציה `three(arr, p)` יחזיר רשימה זהה ל-arr עבור כל ערך p תקין. אם הדבר אינו אפשרי, הסבירו מדוע.
מה מבצעת הפונקציה `three(a, p)` עבור רשימה של מספרים שלמים arr וערך שלם p?
◂ פתרון מלא לשאלה 7
סעיף א
3.0
`one` קוראת ל-`two(num, 0, 0)`. בכל קריאה `two` מורידה את ספרת האחדות (`num % 10`), מוסיפה אותה לסכום `s`, מגדילה את מונה הספרות `c` וממשיכה עם `num // 10`. כש-num מגיע ל-0 מוחזר .
בקריאה האחרונה ו-, ולכן מוחזר , והערך עובר כמו שהוא חזרה עד `one`.
תשובה: 3.0
למשל 2684 (או 555).
`one` מחזירה את ממוצע הספרות (ראו תת-סעיף 3), ולכן צריך מספר גדול מ-100 שממוצע הספרות שלו 5, כלומר סכום הספרות שווה לפי 5 ממספר הספרות.
למשל 2684: ארבע ספרות שסכומן , והממוצע . (גם 555 מתאים: .)
תשובה: 2684.
מחזירה את ממוצע הספרות של num (סכום הספרות חלקי מספר הספרות); עבור 0 מוחזר 0.0.
`two` עוברת על הספרות מימין לשמאל: `s` צובר את סכום הספרות ו-`c` סופר אותן. בסוף מוחזר , כלומר סכום הספרות חלקי מספר הספרות. עבור אין ספרות לעבור עליהן (), והתנאי `if c != 0` מונע חלוקה ב-0 ומחזיר 0.0.
תשובה: `one(num)` מחזירה את ממוצע הספרות של num (מספר עשרוני).
סעיף ב
`[24, 126, 35, 8941, 2684, 9]`
`three(a, 3)` יוצרת רשימה `temp` של 6 אפסים וקוראת ל-`four(a, temp, 0, 0, 5, 3)`. האיבר שמשווים אליו הוא `a[3] = 35`, וממוצע הספרות שלו .
בכל קריאה `four` לוקחת את `a[k]`: אם ממוצע הספרות שלו גדול מ-4.0 הוא נכתב ב-`temp[right]` ו-right קטן ב-1; אחרת הוא נכתב ב-`temp[left]` ו-left גדל ב-1.
ממוצעי הספרות: , , , , , .
הערה: בשאלון המודפס הרשימה נראית כ-`[126,9,35,2684,8941 ,24]` בגלל היפוך כיוון הטקסט (המספר 24 עבר לסוף). אם מתייחסים לסדר הזה, אז `a[3] = 2684` (ממוצע 5.0), ובאותה שיטה מתקבל `[126, 35, 2684, 24, 8941, 9]`.
תשובה: `[24, 126, 35, 8941, 2684, 9]`
כן: כל p שאינו אינדקס חוקי ב-a, כלומר (= len(a)) או , גורם ל-IndexError בגישה `a[p]`.
הערך p משמש רק בביטוי `one(arr[p])` בתוך `four`, והביטוי הזה מחושב כבר בקריאה הראשונה (k=0), כי . לכן השאלה היא אם `a[p]` הוא אינדקס חוקי.
1. ברשימה באורך 6 האינדקסים החוקיים הם 0 עד 5, וב-Python מותרים גם אינדקסים שליליים -1 עד -6 (`a[-1]` הוא האיבר האחרון).
2. לכן עבור (למשל `three(a, 6)`) או הגישה `a[p]` נכשלת ונזרקת שגיאה מסוג `IndexError: list index out of range`.
3. לכל p אחר אין שגיאה: האינדקסים left ו-right תמיד בתחום, כי כל איבר נכתב למקום פנוי אחד בדיוק.
תשובה: כן – כל p מחוץ לתחום האינדקסים של הרשימה (, כלומר , או ) גורם ל-IndexError.
אפשרי, למשל `[11, 11, 11, 11, 11, 11]` או `[5, 55, 46, 64, 19, 91]` (לכל האיברים אותו ממוצע ספרות).
הרעיון: איבר שממוצע הספרות שלו קטן או שווה לזה של `arr[p]` נכתב משמאל, לפי הסדר המקורי. איבר שהממוצע שלו גדול יותר נכתב מהסוף אחורה, כלומר בסדר הפוך. אם לכל האיברים אותו ממוצע ספרות, התנאי `one(arr[k]) > one(arr[p])` לא מתקיים אף פעם, לא משנה מה p. אז כל האיברים נכתבים משמאל לפי הסדר: `temp[0] = arr[0]`, `temp[1] = arr[1]`, ... והרשימה המוחזרת זהה ל-arr.
דוגמאות:
•`[11, 11, 11, 11, 11, 11]` – ממוצע 1.0 לכולם.
•גם עם מספרים שונים: `[5, 55, 46, 64, 19, 91]` – ממוצע 5.0 לכולם (, וכן הלאה).
תשובה: אפשרי, למשל `arr = [5, 55, 46, 64, 19, 91]` (או `[11, 11, 11, 11, 11, 11]`).
מחזירה רשימה חדשה: בתחילתה, לפי הסדר המקורי, האיברים שממוצע הספרות שלהם קטן או שווה לממוצע הספרות של `arr[p]`, ובסופה, בסדר הפוך, האיברים שממוצע הספרות שלהם גדול ממנו.
`four` עוברת על האיברים לפי הסדר (k עולה) ומשווה את ממוצע הספרות של כל איבר (`one`) לממוצע הספרות של האיבר במקום p:
•ממוצע קטן או שווה – האיבר נכתב במקום הפנוי הבא משמאל (left עולה), ולכן האיברים האלה מופיעים בתחילת הרשימה לפי הסדר המקורי.
•ממוצע גדול – האיבר נכתב במקום הפנוי הבא מימין (right יורד), ולכן האיברים האלה מופיעים בסוף הרשימה בסדר הפוך לסדר שלהם במקור.
הרשימה המקורית לא משתנה; נוצרת רשימה חדשה `temp`. זו חלוקה (partition) של הרשימה סביב "ציר" – ממוצע הספרות של `arr[p]`.
תשובה: `three` מחזירה רשימה חדשה שבה כל האיברים שממוצע הספרות שלהם קטן או שווה לממוצע הספרות של `arr[p]` נמצאים בהתחלה (בסדר המקורי), ושאר האיברים בסוף (בסדר הפוך).
שאלה 8 · תפזורת: חיפוש מילה במטריצה
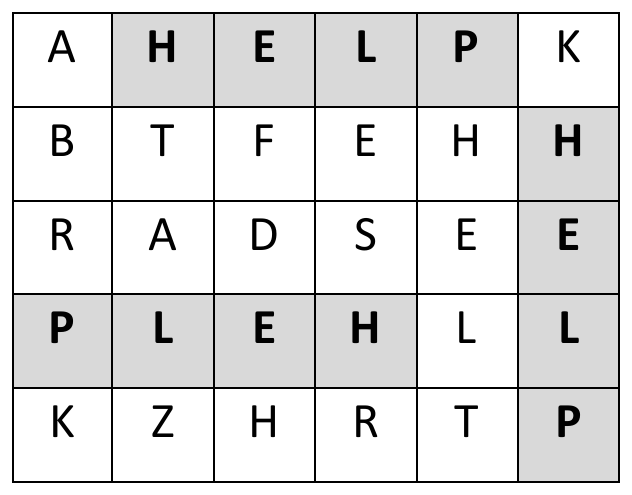
במשחק תפזורת (WordSearch) הפותר צריך לחפש בתוך מטריצה (רשימה של רשימות) של אותיות, רצפים של אותיות המרכיבים את המילה הנתונה. כיוון קריאת המילים יכול להיות מימין לשמאל, משמאל לימין, מלמעלה למטה ומלמטה למעלה.
לדוגמה, המילה "HELP" מופיעה במטריצה שלפניכם שלוש פעמים:
[['A', 'H', 'E', 'L', 'P', 'K'],
 ['B', 'T', 'F', 'E', 'H', 'H'],
 ['R', 'A', 'D', 'S', 'E', 'E'],
 ['P', 'L', 'E', 'H', 'L', 'L'],
 ['K', 'Z', 'H', 'R', 'T', 'P']]
כתבו פונקציה המקבלת מטריצה דו-ממדית של אותיות arr ומילה word. על הפונקציה לבדוק אם המילה מופיעה במערך (לפי כללי המשחק תפזורת). אם כן – הפונקציה תחזיר ערך True, ואם לא – הפונקציה תחזיר ערך False.
כותרת הפונקציה:
def exist(arr, word)◂ פתרון מלא לשאלה 8
פתרון
לכל משבצת ולכל אחד מארבעת הכיוונים (ימינה, שמאלה, למטה, למעלה) בודקים, אם המילה נכנסת במטריצה, שכל אותיותיה מתאימות; בהתאמה מלאה מחזירים True, ואם לא נמצאה – False.
הרעיון: מילה יכולה להתחיל בכל משבצת ולהתקדם באחד מארבעה כיוונים. נייצג כיוון כזוג `(dr, dc)` – בכמה משתנה מספר השורה ובכמה מספר העמודה בכל צעד:
•משמאל לימין: `(0, 1)`
•מימין לשמאל: `(0, -1)`
•מלמעלה למטה: `(1, 0)`
•מלמטה למעלה: `(-1, 0)`
האות ה-k של המילה (k מתחיל ב-0) נמצאת אז במשבצת `[r + dr*k][c + dc*k]`.
1. עוברים על כל משבצת התחלה `(r, c)` ועל כל אחד מארבעת הכיוונים.
2. בדיקת גבולות: מחשבים איפה תיפול האות האחרונה, `(r + dr*(n-1), c + dc*(n-1))`. אם המשבצת הזאת מחוץ למטריצה, המילה לא נכנסת בכיוון הזה ומדלגים עליו. כך לא יוצאים מגבולות הרשימה. (צריך לבדוק רק את הקצה, כי המשבצות שבדרך נמצאות בין משבצת ההתחלה לקצה.)
3. השוואת אותיות: מתקדמים עם k כל עוד האות במשבצת שווה ל-`word[k]`. אם k הגיע ל-n (אורך המילה), כל האותיות התאימו – מחזירים `True`.
4. אם עברנו על כל המשבצות ועל כל הכיוונים בלי התאמה – מחזירים `False`.
def exist(arr, word):
    rows = len(arr)
    cols = len(arr[0])
    n = len(word)
    # ארבעה כיוונים: ימינה, שמאלה, למטה, למעלה
    directions = [(0, 1), (0, -1), (1, 0), (-1, 0)]
    for r in range(rows):
        for c in range(cols):
            for dr, dc in directions:
                # המשבצת של האות האחרונה חייבת להיות בתוך המטריצה
                end_r = r + dr * (n - 1)
                end_c = c + dc * (n - 1)
                if 0 <= end_r < rows and 0 <= end_c < cols:
                    k = 0
                    while k < n and arr[r + dr * k][c + dc * k] == word[k]:
                        k = k + 1
                    if k == n:
                        return True
    return False
בדיקה עם הדוגמה: המילה HELP נמצאת:
•בשורה 0, החל מ-`[0][1]`, בכיוון `(0, 1)` – H, E, L, P.
•בשורה 3, החל מ-`[3][3]`, בכיוון `(0, -1)` – H (`[3][3]`), E (`[3][2]`), L (`[3][1]`), P (`[3][0]`).
•בעמודה 5, החל מ-`[1][5]`, בכיוון `(1, 0)` – H, E, L, P.
כבר ההופעה הראשונה נמצאת בסריקה, ולכן מוחזר `True`. לעומת זאת, עבור המילה "ZE" מוחזר `False`: מתחת ל-Z (שורה 4) אין שורה, ומעליו, מימינו ומשמאלו האותיות L, H ו-K.
סיבוכיות: עבור מטריצה של ומילה באורך : .
תשובה: הפונקציה `exist` שלמעלה.
שאלה 9 · מחלקות חשבון ומשתמשים: אבטחת סיסמאות
המערכת "ארגונית" לניהול חשבונות משתמשים כוללת שתי מחלקות: Account ו-Users.
למחלקה Account כמה תכונות:
•שם משתמש – username, מסוג מחרוזת, str
•הסיסמה הנוכחית – current_pass, מסוג מחרוזת, str
•סיסמאות קודמות – pass_history, מסוג רשימה של 10 מחרוזות, `list[str]`. המערך ישמור עד 10 סיסמאות קודמות של החשבון.
כתבו בנאי (`__init__`) למחלקה Account שמקבל שם משתמש וסיסמה ראשונית כפרמטרים.
הבנאי יאתחל את username, יאחסן את הסיסמה הראשונית ב-current_pass ובמקום הראשון ברשימה pass_history.
במערכת קיימת דרישת אבטחה לסיסמאות: הסיסמה תקינה אם היא עונה לפחות לשלושה מתוך חמישה תנאים:
•הסיסמה צריכה להיות באורך של שמונה תווים לפחות.
•הסיסמה צריכה להכיל שתי אותיות גדולות ('A'–'Z') לפחות.
•הסיסמה צריכה להכיל ספרה אחת ('0'–'9') לפחות.
•הסיסמה צריכה להכיל תו מיוחד אחד לפחות (כל תו שאינו אות או ספרה).
•בסיסמה אין תווים זהים צמודים.
כתבו במחלקה Account את הפונקציה is_password_valid המקבלת מחרוזת ובודקת אם היא יכולה להיות סיסמה.
כתבו במחלקה Account את הפונקציה update_password המקבלת כפרמטר סיסמה חדשה. הסיסמה החדשה צריכה להיות תקינה. אם היא לא תקינה, הפונקציה לא מבצעת עדכון ומדפיסה הודעה מתאימה. הסיסמה החדשה צריכה להיות גם שונה מסיסמה הנוכחית ומסיסמאות הקודמות. אם היא זהה, הפונקציה לא תבצע עדכון ותדפיס הודעה מתאימה.
אם הסיסמה החדשה תקינה ואינה זהה לאף אחת מהסיסמאות הקודמות, הפונקציה תעדכן את current_pass לסיסמה החדשה, ותוסיף את הסיסמה החדשה לתחילת הרשימה pass_history, תוך כדי הזזת הסיסמאות הקיימות (אם הרשימה מלאה, הסיסמה הישנה ביותר תידרס).
למחלקה Users שתי תכונות:
•חשבונות משתמשים – accounts, מסוג רשימת עצמים מסוג Account, בגודל מקסימלי של 100.
•מספר משתמשים פעילים – num_of_accounts, מסוג מספר שלם, int.
כתבו במחלקה Users את הפונקציה add_user המקבלת שם משתמש וסיסמה ראשונית כפרמטרים.
תחילה הפונקציה תבדוק אם כבר קיים חשבון עם שם המשתמש הזה. אם קיים או אם אין מקום, הפונקציה לא תוסיף משתמש חדש ותדפיס הודעה מתאימה.
אם שם המשתמש לא קיים והרשימה accounts אינה מלאה, הפונקציה תיצור אובייקט חדש מסוג Account, תוסיף אותו לרשימה accounts ותעדכן את num_of_accounts.
עקב ריבוי ניסיונות פריצה מצד גורמים זרים, הוחלט להקשיח את דרישות האבטחה לסיסמאות של המשתמשים. בהתאם לכך:
•הציעו לפחות שני שיפורים נוספים לחיזוק הסיסמאות, אשר יתווספו לתנאים לסיסמה תקינה.
•כתבו פונקציה המאפשרת לקבל את רשימת המשתמשים הנדרשים לחיזוק הסיסמה ולצד כל משתמש את רשימת התנאים בהם סיסמתו הישנה אינה עומדת. נא הדפיסו הודעה מתאימה!
•ממשו את השינויים הנדרשים בהתאם לשיפורים כפי שהצעתם במחלקה אחת או יותר. יש לתעד היטב את הצעתכם.
◂ פתרון מלא לשאלה 9
סעיף א
`username = username`, `current_pass = password`, `pass_history = [password]`.
הבנאי שומר את שם המשתמש, שומר את הסיסמה הראשונית כסיסמה הנוכחית, ויוצר את רשימת ההיסטוריה כשהסיסמה הראשונית במקום 0 שלה. הרשימה תגדל עד 10 סיסמאות (ראו סעיף ג).
class Account:
    def __init__(self, username, password):
        self.username = username
        self.current_pass = password
        self.pass_history = [password]
תשובה: הבנאי שלמעלה.
סעיף ב
סופרים כמה מחמשת התנאים מתקיימים (אורך ≥ 8, לפחות 2 אותיות גדולות, ספרה, תו מיוחד, אין תווים זהים צמודים) ומחזירים True אם מתקיימים לפחות 3.
הרעיון: מונה `conditions` סופר כמה מהתנאים מתקיימים, ובסוף מחזירים `conditions >= 3`.
1. אורך: `len(password) >= 8`.
2. אותיות גדולות, ספרות ותווים מיוחדים: במעבר אחד על התווים סופרים אותיות גדולות (`'A' <= ch <= 'Z'`), ספרות (`'0' <= ch <= '9'`) ותווים מיוחדים – תו שאינו אות ואינו ספרה (`not ch.isalnum()`). אחר כך בודקים: לפחות 2 אותיות גדולות, לפחות ספרה אחת, לפחות תו מיוחד אחד. כל תנאי שמתקיים מוסיף 1.
3. תווים זהים צמודים: משווים כל תו לתו שאחריו (`i` עד `len - 2`, כדי ש-`i + 1` לא יחרוג). אם לא נמצא זוג זהה – התנאי מתקיים.
4. מחזירים `True` אם מתקיימים 3 תנאים לפחות.
def is_password_valid(self, password):
    conditions = 0
    # 1. אורך של 8 תווים לפחות
    if len(password) >= 8:
        conditions = conditions + 1
    # 2-4. ספירת אותיות גדולות, ספרות ותווים מיוחדים
    upper = 0
    digits = 0
    special = 0
    for ch in password:
        if 'A' <= ch <= 'Z':
            upper = upper + 1
        elif '0' <= ch <= '9':
            digits = digits + 1
        elif not ch.isalnum():      # לא אות ולא ספרה
            special = special + 1
    if upper >= 2:
        conditions = conditions + 1
    if digits >= 1:
        conditions = conditions + 1
    if special >= 1:
        conditions = conditions + 1
    # 5. אין שני תווים זהים צמודים
    repeated = False
    for i in range(len(password) - 1):
        if password[i] == password[i + 1]:
            repeated = True
    if not repeated:
        conditions = conditions + 1
return conditions >= 3•`"Ab1!xyzw"` – אורך 8 ✓, אות גדולה אחת בלבד ✗, ספרה ✓, תו מיוחד ✓, אין זהים צמודים ✓ – 4 תנאים, תקינה.
•`"Password1"` – אורך 9 ✓, אות גדולה אחת ✗, ספרה ✓, אין תו מיוחד ✗, "ss" צמודים ✗ – 2 תנאים, לא תקינה.
תשובה: הפעולה `is_password_valid` שלמעלה.
סעיף ג
אם הסיסמה לא תקינה או כבר הופיעה (נוכחית או בהיסטוריה) – הודעה ואין עדכון; אחרת `current_pass = new_pass`, `pass_history.insert(0, new_pass)`, ואם יש יותר מ-10 מוחקים את האחרונה.
1. תקינות: בודקים בעזרת `is_password_valid` מסעיף ב. אם לא תקינה – מדפיסים הודעה ויוצאים (`return`) בלי לשנות דבר.
2. סיסמה ששימשה בעבר: אם היא שווה לסיסמה הנוכחית או מופיעה ב-`pass_history` (בדיקה עם `in`) – מדפיסים הודעה ויוצאים.
3. עדכון: מעדכנים את `current_pass`, ומכניסים את הסיסמה לתחילת ההיסטוריה עם `insert(0, ...)`, שמזיז את כל הסיסמאות הקיימות מקום אחד ימינה.
4. הגבלה ל-10: אם אחרי ההכנסה יש ברשימה יותר מ-10 סיסמאות, מוחקים את האחרונה (`pop()`), שהיא הישנה ביותר.
def update_password(self, new_pass):
    if not self.is_password_valid(new_pass):
        print("הסיסמה אינה תקינה, לא בוצע עדכון")
        return
    if new_pass == self.current_pass or new_pass in self.pass_history:
        print("הסיסמה כבר הייתה בשימוש, לא בוצע עדכון")
        return
    self.current_pass = new_pass
    self.pass_history.insert(0, new_pass)
    if len(self.pass_history) > 10:
        self.pass_history.pop()      # הסיסמה הישנה ביותר נדרסת
דוגמה: אחרי 12 עדכונים מוצלחים לסיסמאות שונות, ברשימה נשארות 10 סיסמאות: החדשה ביותר במקום 0, והישנות נמחקו. ניסיון לחזור לאחת מהן יידחה.
תשובה: הפעולה `update_password` שלמעלה.
סעיף ד
מחפשים את שם המשתמש ב-accounts; אם קיים או ש-num_of_accounts כבר 100 – הודעה; אחרת יוצרים `Account(username, password)`, מוסיפים לרשימה ומגדילים את num_of_accounts ב-1.
נניח שבנאי המחלקה Users מאתחל רשימה ריקה `accounts` ומונה `num_of_accounts = 0`.
1. שם קיים: עוברים על החשבונות ברשימה. אם לאחד מהם אותו `username` – מדפיסים הודעה ויוצאים.
2. אין מקום: אם `num_of_accounts` כבר 100 – מדפיסים הודעה ויוצאים.
3. הוספה: יוצרים חשבון חדש עם הבנאי מסעיף א, מוסיפים אותו לסוף הרשימה ומגדילים את המונה ב-1.
class Users:
    def __init__(self):
        self.accounts = []
        self.num_of_accounts = 0

    def add_user(self, username, password):
        for acc in self.accounts:
            if acc.username == username:
                print("שם המשתמש כבר קיים")
                return
        if self.num_of_accounts >= 100:
            print("אין מקום למשתמשים נוספים")
            return
        self.accounts.append(Account(username, password))
        self.num_of_accounts = self.num_of_accounts + 1
תשובה: הפעולה `add_user` שלמעלה.
סעיף ה
שני תנאים חדשים: לפחות אות קטנה אחת, והסיסמה לא מכילה את שם המשתמש. ב-Account – `failed_conditions` שמחזירה את רשימת התנאים שלא מתקיימים, ו-`is_password_valid` דורשת לפחות 5 מתוך 7 תנאים. ב-Users – `weak_passwords_report` שמדפיסה כל משתמש שסיסמתו הנוכחית לא תקינה עם התנאים שלא מתקיימים, ומחזירה רשימת זוגות (שם, תנאים).
השיפורים המוצעים (נוספים לחמשת התנאים הקיימים):
1. אות קטנה: הסיסמה צריכה להכיל לפחות אות קטנה אחת ('a'–'z'). סיסמה עם אותיות משני הסוגים מגדילה את מספר הצירופים האפשריים.
2. בלי שם המשתמש: הסיסמה לא תכיל את שם המשתמש (בלי הבדל בין אותיות גדולות לקטנות). זה הדבר הראשון שתוקף מנסה.
כלל התקינות החדש: יש עכשיו 7 תנאים. כדי להקשיח את הדרישה (קודם 3 מתוך 5), סיסמה תקינה צריכה לעמוד ב-5 מתוך 7 תנאים לפחות, כלומר לכל היותר 2 תנאים לא מתקיימים.
1. במחלקה Account – `failed_conditions(password)`: בודקת את כל 7 התנאים ומחזירה רשימה של תיאורי התנאים שלא מתקיימים. כך אותה בדיקה משמשת גם להחלטה על תקינות וגם לדוח.
2. במחלקה Account – `is_password_valid(password)`: מחליפה את הגרסה מסעיף ב ומחזירה `True` אם ברשימת התנאים שנכשלו יש לכל היותר 2. מכיוון ש-`update_password` קוראת לה, גם סיסמאות חדשות ייבדקו מעכשיו לפי הכלל החדש.
3. במחלקה Users – `weak_passwords_report()`: עוברת על כל החשבונות; לכל חשבון שהסיסמה הנוכחית שלו לא תקינה לפי הכלל החדש, מדפיסה את שם המשתמש ואת התנאים שלא מתקיימים, ומוסיפה זוג (שם, רשימת תנאים) לרשימת התוצאה. אם אין אף משתמש כזה, מדפיסה הודעה שכל הסיסמאות עומדות בדרישות. הפונקציה מחזירה את הרשימה, למקרה שרוצים להשתמש בה בהמשך (למשל לשלוח למשתמשים בקשה להחלפת סיסמה).
def failed_conditions(self, password):
    """מחזירה רשימה של שמות התנאים שהסיסמה אינה עומדת בהם"""
    failed = []
    if len(password) < 8:
        failed.append("אורך קטן מ-8")
    upper = 0
    lower = 0
    digits = 0
    special = 0
    for ch in password:
        if 'A' <= ch <= 'Z':
            upper = upper + 1
        elif 'a' <= ch <= 'z':
            lower = lower + 1
        elif '0' <= ch <= '9':
            digits = digits + 1
        elif not ch.isalnum():
            special = special + 1
    if upper < 2:
        failed.append("פחות משתי אותיות גדולות")
    if digits < 1:
        failed.append("אין ספרה")
    if special < 1:
        failed.append("אין תו מיוחד")
    for i in range(len(password) - 1):
        if password[i] == password[i + 1]:
            failed.append("יש תווים זהים צמודים")
            break
    # שיפור 1 (חדש): לפחות אות קטנה אחת
    if lower < 1:
        failed.append("אין אות קטנה")
    # שיפור 2 (חדש): הסיסמה לא מכילה את שם המשתמש
    if self.username.lower() in password.lower():
        failed.append("מכילה את שם המשתמש")
    return failed

def is_password_valid(self, password):
    # תקינה אם היא עומדת לפחות ב-5 מתוך 7 התנאים
    return len(self.failed_conditions(password)) <= 2
def weak_passwords_report(self):
weak = []
for acc in self.accounts:
if not acc.is_password_valid(acc.current_pass):
failed = acc.failed_conditions(acc.current_pass)
weak.append((acc.username, failed))
print("המשתמש", acc.username, "נדרש לחזק את הסיסמה. תנאים שלא מתקיימים:",
", ".join(failed))
if len(weak) == 0:
print("כל הסיסמאות עומדות בדרישות האבטחה החדשות")
return weakדוגמה: למשתמש dana עם הסיסמה `"Dana2024!!"`: יש רק אות גדולה אחת, יש "!!" צמודים, והסיסמה מכילה את "dana" – 3 תנאים לא מתקיימים, ולכן יודפס:
המשתמש dana נדרש לחזק את הסיסמה. תנאים שלא מתקיימים: פחות משתי אותיות גדולות, יש תווים זהים צמודים, מכילה את שם המשתמש.
למשתמש עם `"Ab1!cdefG"` כל 7 התנאים מתקיימים, והוא לא יופיע בדוח.
תשובה: השיפורים: אות קטנה חובה, ואיסור על שם המשתמש בסיסמה; הפעולות `failed_conditions` ו-`is_password_valid` (5 מתוך 7) ב-Account, והפעולה `weak_passwords_report` ב-Users.
שאלה 10 · מעקב: היפוך קטעים וסיבוב רשימה
נתונות שתי הפעולות what ו-secret, ושתי פעולות העזר why ו-mystery.
def secret(a, s):
    s %= len(a)
    mystery(a, 0, len(a) - 1)
    mystery(a, 0, s - 1)
    mystery(a, s, len(a) - 1)

def mystery(a, start, end):
    while start < end:
        temp = a[start]
        a[start] = a[end]
        a[end] = temp
        start += 1
        end -= 1

def what(a, d):
    why(a, d, 0)

def why(a, d, i):
    if i<len(a):
        j = (i + d) % len(a)
        rest = a[j]
        why(a, d, i + 1)
        a[i] = rest
נתונה הרשימה arr של מספרים שלמים:
[10, 3, 6, 8, 2, 11, 5]עקבו אחרי זימון הפונקציה `mystery(arr, 1, 4)` ורשמו מה יהיה תוכן הרשימה אחרי הזימון.
עקבו אחרי זימון הפונקציה `secret(arr, 3)` ורשמו מה יהיה תוכן הרשימה אחרי הזימון.
מה מבצעת הפונקציה `secret(a, d)` עבור רשימה של מספרים שלמים a ומספר שלם וחיובי d?
עקבו אחרי זימון הפונקציה `what(arr, 3)` ורשמו מה יהיה תוכן הרשימה אחרי הזימון.
אחרי זימון הפונקציה `what(brr, 2)` התקבלה הרשימה brr:
[10, 20, 30, 40, 50, 60]מה היה תוכן הרשימה brr לפני זימון הפונקציה?
מה מבצעת הפונקציה `what(a, d)` עבור רשימה של מספרים שלמים a ומספר שלם וחיובי d?
◂ פתרון מלא לשאלה 10
סעיף א
`[10, 2, 8, 6, 3, 11, 5]`
`mystery(a, start, end)` מחליפה את `a[start]` עם `a[end]`, מקדמת את start ב-1 ומורידה את end ב-1, כל עוד `start < end`. כך היא הופכת את סדר האיברים בקטע שבין האינדקסים start ו-end.
תשובה: `[10, 2, 8, 6, 3, 11, 5]`
סעיף ב
`[2, 11, 5, 10, 3, 6, 8]` (על הרשימה המקורית)
נבצע את הזימון על הרשימה המקורית `[10, 3, 6, 8, 2, 11, 5]`.
1. `s %= len(a)`: .
2. `mystery(a, 0, 6)` – היפוך כל הרשימה: `[5, 11, 2, 8, 6, 3, 10]`.
3. `mystery(a, 0, 2)` – היפוך שלושת האיברים הראשונים (5, 11, 2): `[2, 11, 5, 8, 6, 3, 10]`.
4. `mystery(a, 3, 6)` – היפוך ארבעת האחרונים (8, 6, 3, 10): `[2, 11, 5, 10, 3, 6, 8]`.
השלושה האחרונים במקור (2, 11, 5) עברו להתחלה, וכל השאר זזו 3 מקומות ימינה.
הערה: אם מבצעים את הזימון על הרשימה אחרי סעיף א (`[10, 2, 8, 6, 3, 11, 5]`), אותם שלבים נותנים `[3, 11, 5, 10, 2, 8, 6]`.
תשובה: `[2, 11, 5, 10, 3, 6, 8]`
סעיף ג
מסובבת את הרשימה ימינה (סיבוב מעגלי) ב-d מקומות: האיבר שבמקום i עובר למקום .
`secret` משתמשת בשיטת שלושת ההיפוכים:
1. `s %= len(a)` – סיבוב ב-n מקומות מחזיר את הרשימה למצבה, ולכן מספיק לסובב ב-.
2. היפוך כל הרשימה מעביר את s האיברים האחרונים להתחלה, אבל בסדר הפוך, ואת השאר לסוף, גם הם בסדר הפוך.
3. היפוך s האיברים הראשונים והיפוך שאר האיברים מחזירים כל חלק לסדר המקורי שלו.
התוצאה: s האיברים האחרונים עברו להתחלה, וכל האיברים האחרים זזו s מקומות ימינה. הפעולה משנה את הרשימה עצמה במקום, בלי רשימת עזר, ב-.
תשובה: `secret(a, d)` מבצעת סיבוב מעגלי ימינה של הרשימה ב-d מקומות ().
סעיף ד
`[8, 2, 11, 5, 10, 3, 6]` (על הרשימה המקורית)
נבצע את הזימון על הרשימה המקורית `[10, 3, 6, 8, 2, 11, 5]` (, ).
`what(arr, 3)` קוראת ל-`why(arr, 3, 0)`. בכל זימון `why` מחשבת ושומרת ב-`rest` את `a[j]` לפני הקריאה הרקורסיבית. את ההשמה `a[i] = rest` היא מבצעת רק אחרי שהקריאה חוזרת. לכן כל הקריאות מהרשימה קורות בדרך "למטה", כשהרשימה עדיין לא שונתה, וכל הכתיבות קורות בדרך "חזרה".
`a[6] = 6`, `a[5] = 3`, `a[4] = 10`, `a[3] = 5`, `a[2] = 11`, `a[1] = 2`, `a[0] = 8`.
התוצאה: `[8, 2, 11, 5, 10, 3, 6]` – כל איבר קיבל את הערך שהיה 3 מקומות אחריו (מעגלית).
הערה: אם מבצעים את הזימון על הרשימה אחרי סעיף א (`[10, 2, 8, 6, 3, 11, 5]`), מתקבל באותה דרך `[6, 3, 11, 5, 10, 2, 8]`.
תשובה: `[8, 2, 11, 5, 10, 3, 6]`
סעיף ה
`[50, 60, 10, 20, 30, 40]`
כפי שראינו בסעיף ד, `what(a, d)` שמה בכל מקום i את הערך שהיה במקום , כלומר מסובבת שמאלה ב-d מקומות. כדי למצוא את הרשימה המקורית מבצעים את הפעולה ההפוכה – סיבוב ימינה ב-2 מקומות (): הערך שנמצא עכשיו במקום i היה קודם במקום .
לכן לפני הזימון: `brr = [50, 60, 10, 20, 30, 40]`.
בדיקה: `what([50, 60, 10, 20, 30, 40], 2)`: `a[0] = a[2] = 10`, `a[1] = a[3] = 20`, ... , `a[4] = a[0] = 50`, `a[5] = a[1] = 60` – מתקבל `[10, 20, 30, 40, 50, 60]`.
תשובה: `[50, 60, 10, 20, 30, 40]`
סעיף ו
מסובבת את הרשימה שמאלה (סיבוב מעגלי) ב-d מקומות: `a[i]` מקבל את הערך שהיה ב-`a[(i+d) % n]`.
`why` שומרת לכל i את הערך `a[(i + d) % len(a)]` לפני הקריאה הרקורסיבית, ומשבצת אותו ב-`a[i]` רק בחזרה מהרקורסיה. כל הקריאות מהרשימה קורות לפני הכתיבה הראשונה, ולכן אף ערך לא נדרס לפני שנקרא. ערכי `rest` שבזימונים הפתוחים משמשים כאן כמו רשימת עזר.
לכן בסוף, בכל מקום i נמצא הערך שהיה d מקומות אחריו (מעגלית): d האיברים הראשונים עוברים לסוף, וכל השאר זזים d מקומות שמאלה. זו הפעולה ההפוכה של `secret` מסעיף ג.
תשובה: `what(a, d)` מבצעת סיבוב מעגלי שמאלה של הרשימה ב-d מקומות.